

推しアイデア
自分のノートPCがその場でAIの一部になる、という体験そのものが本命です。QRを読んだ瞬間に計算が始まって、自分が担当した層が画面で光る。それを会場のみんなが見ている、というライブ感を大事にしました。
―
自分のノートPCがその場でAIの一部になる、という体験そのものが本命です。QRを読んだ瞬間に計算が始まって、自分が担当した層が画面で光る。それを会場のみんなが見ている、というライブ感を大事にしました。
1台には載らないデカいLLMも、会場にいる人のPCをちょっとずつ借りれば動くのでは、という思いつきから。モデルも計算も会場のLANから出さない構成にしています。
制御はHonoのWebSocket、実データはWebRTCで直接P2P、と2層に分けたのが肝です。Honoは「誰がいるか」「いつ始めるか」だけ喋って、重いデータには触りません。ブラウザで動くWASM版llama.cppと繋いで、インストールなしで参加できます。
(ollamaじゃなくてllama.cppだけど)
↑ここから参加できます (LAN内でサーバーが立っている時のみ)
会場のLAN内で、複数台のブラウザの計算資源を集めて1つのLLMを動かそうぜ!!うおぉーーーーー!!!!! 有線で繋いだ方がいい?ブラウザで繋ぐ実装コスト?そんなの妄想だって?ロマンです!!!
人が増えるほど、1台では載らないサイズのモデルが動くようになります。参加はQRを読んでページを開くだけで、インストールもアカウント登録も不要!
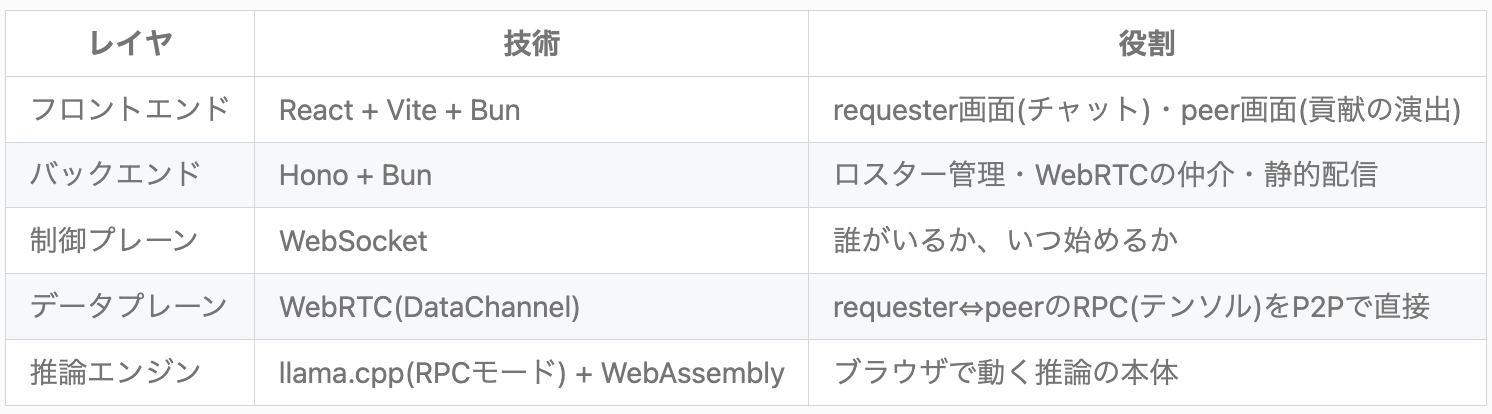
equesterのRuntimeがHonoから1回だけ落として、peerには計算に必要なぶんだけWebRTCで飛びます。peerはモデルファイルを持たない。
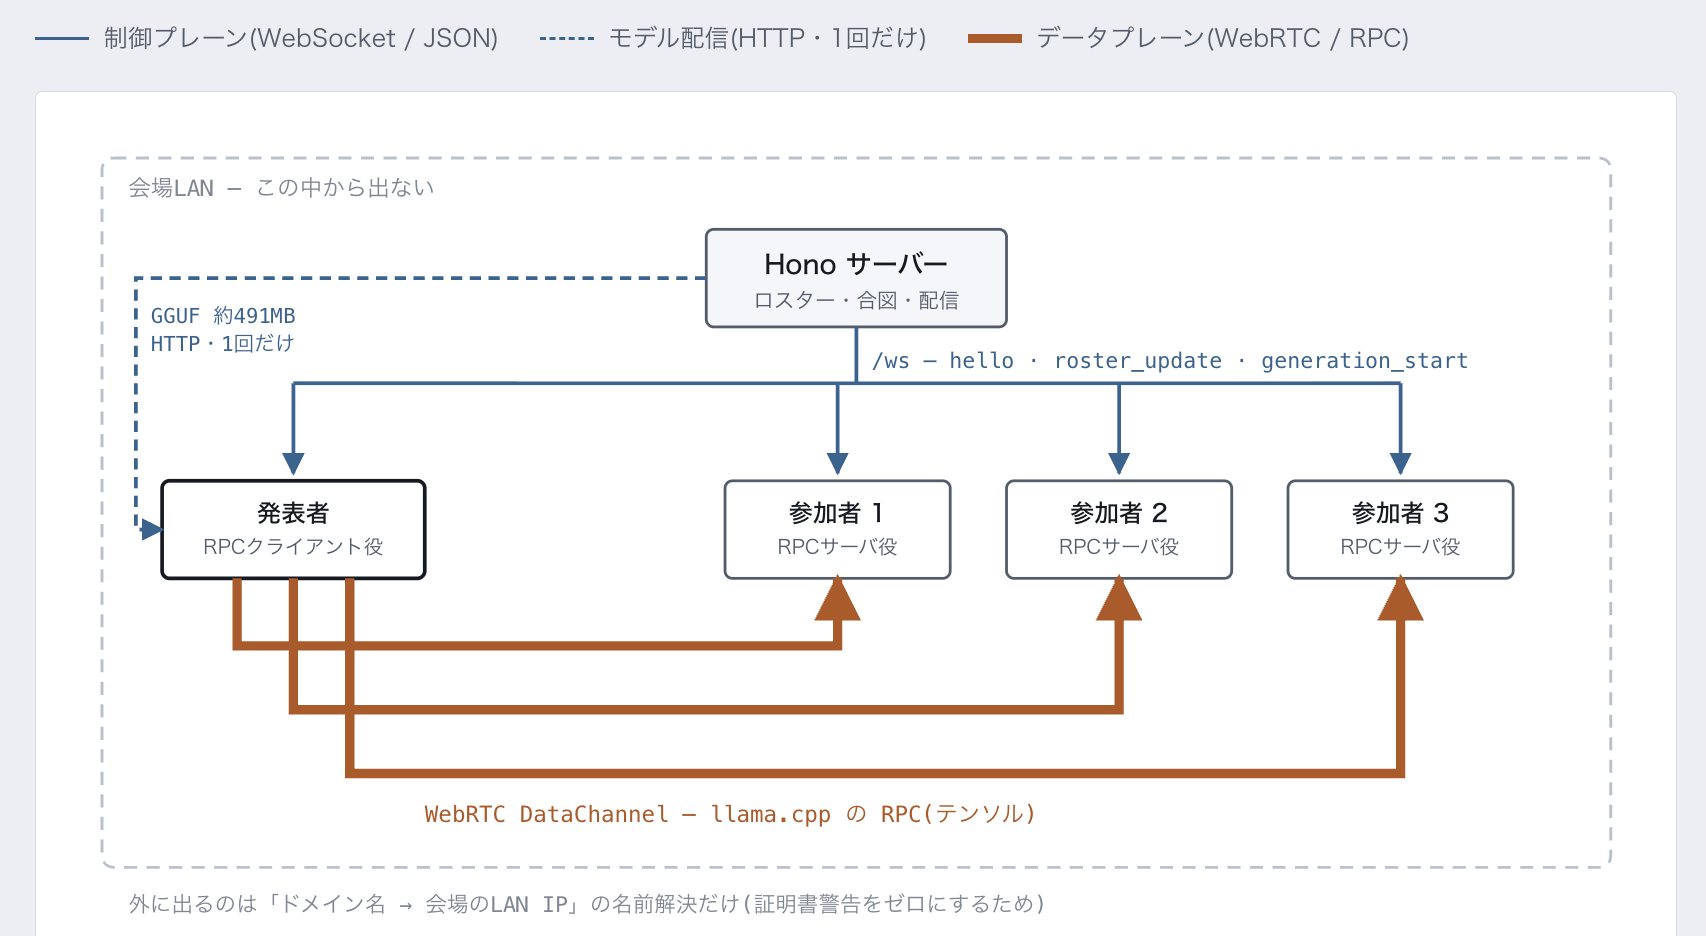
1. 星型トポロジー
requesterがpeer1人ずつと個別にWebRTCで繋がります。llama.cppのRPCがそもそも星型なので、peer同士は繋がなくて済みます。
2. 制御とデータを分ける
Honoが喋るのは「誰が来た」「いま始めていい」くらいの軽いJSONだけで、推論のテンソルは一切通しません。
サーバーが中継すると、同じデータが会場の無線を2回通ることになります。そこが詰まるのは目に見えていたので、設計の段階でここだけは譲らないと決めました。
3. 世代(generation)で区切って組み直す
会場だと推論の最中にも人が増えます。かといってpeerが来るたびに編成を組み替えると生成が壊れるので、「次の生成が始まるとき」にだけ反映する形にしました。
ここは作りながら育った部分で、メッセージを3つ増やしました。
requester_accepting … 生成中に来たpeerをいま取り込んでいいか、requester側が決める。断っている間は溜めておいて、OKした瞬間にまとめて1回だけ組み直すgeneration_failed … 編成したけど繋がらなかった、をサーバーに伝えるgeneration_aborted の理由 … 「増えた」「減った」「繋がらなかった」を分けて画面に出す最初は「増減したら組み直す」だけのつもりでした。でも実際に動かしたら、繋がらないまま「生成中」で固まる経路が見つかって、それを塞ぐために契約が増えていった感じです。
技術の無駄遣い
地味ですが、ここに割とハマりました
ブラウザでWASM版llama.cppを動かすには、pthread(SharedArrayBuffer)のためにHTTPSとCOOP/COEPが要ります。ところが開発で使うmkcertの証明書は、自分のPCでしか信頼されません。つまり会場で飛び入りしてくれた人のPCには証明書の警告が出ます。せっかくQRで気軽に参加できるのに、そこでUXが最悪に。
なので、リタ所有の実在ドメインに対してLet's Encryptの証明書をDNS-01で取って、そのドメインのAレコードが会場LANのプライベートIPを指すようにしました。DNS-01はTXTレコードを一時的に置けるかしか見ないので、サーバーが外から見える必要がありません。
この構成で外に出るのは「ドメイン名 → 会場のLAN IP」を引くところだけです。モデルもテンソルも制御メッセージも、会場のLANから外に出ません。
WASM版llama.cpp + WebRTCという土台は、llmletという先行プロジェクトを参考にしています。ここからの差分がプロジェクトの中身そのものなので、少し詳しく書きます。
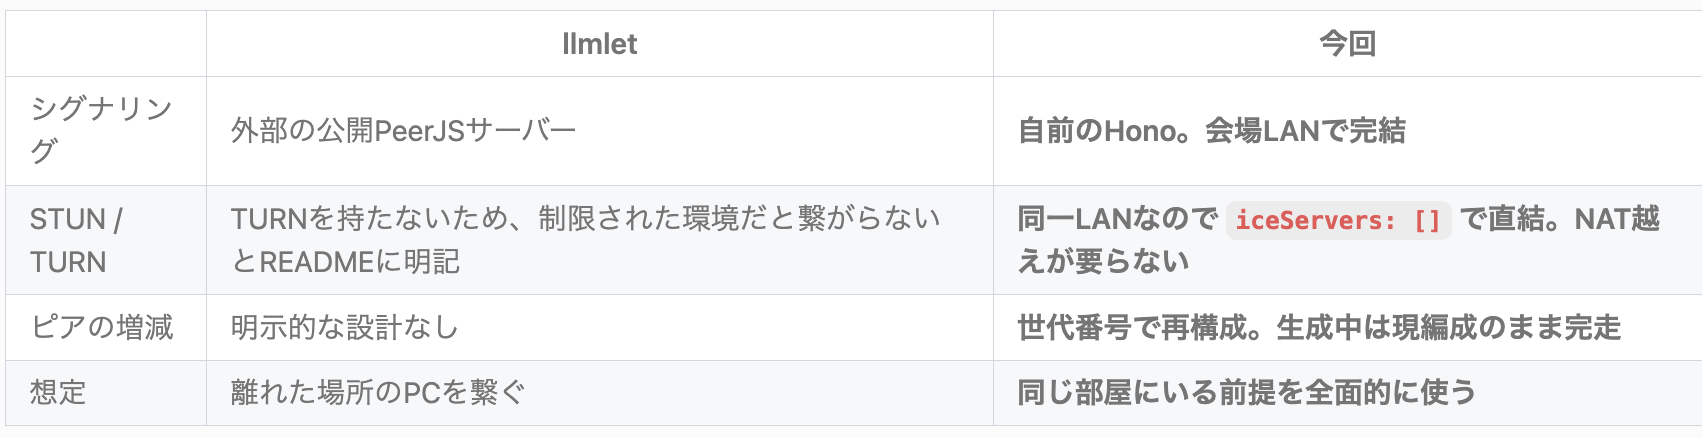
一番効いているのは2行目。llmlet自身が「TURNが無いので繋がらない環境がある」と書いていますが、同一LANならその心配はなし。ICEの候補もローカルのものだけで済むので、接続が速くて安定します。
「LANに限定した」のは制約に見えて、実際はこのプロジェクトの前提そのもの
同一LANだからこそ塞がないといけなかった穴
bufferedAmount が16MiBに達した時点で例外を投げます。8MiBで一度待ち合わせる水位を入れて、溢れる前に止めるようにしましたllama.cppをコンパイラ(Emscripten)でWASMにしてブラウザ上で動かし、ネットワーク通信部分をWebRTC DataChannelにつなぎ替えています。
つまり、参加者は専用ソフトをインストールしなくても、URLを開くだけでブラウザをllama.cppのRPC計算ノードとして参加させられます。
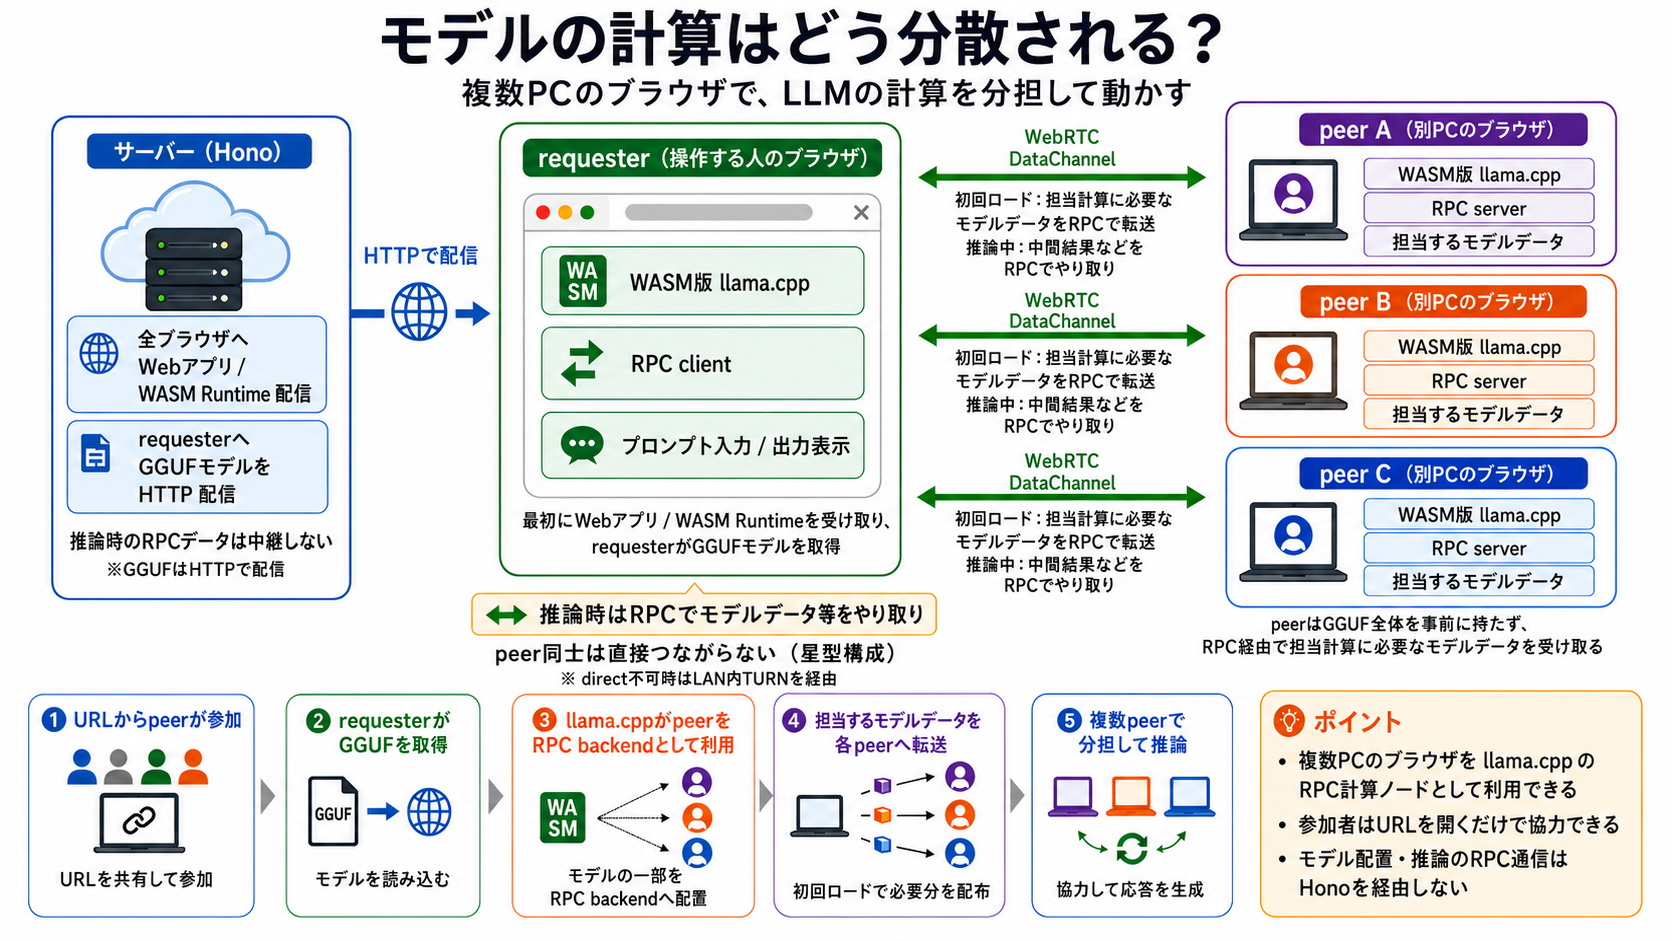
大まかな流れは、
① URLからpeerが参加 ↓ ② requesterがGGUFモデルを取得 ↓ ③ llama.cppがpeerをRPC backendとして利用 ↓ ④ 担当するモデルデータを各peerへ転送 ↓ ⑤ 複数peerで分担して推論
Honoは全ブラウザへWebアプリとWASM Runtimeを配信し、requesterへGGUFモデルをHTTPで配信します。
一方、モデル配置や推論時のRPC通信はHonoを経由せず、requesterとpeerのWebRTC DataChannel上でやり取りします。
peer同士は直接接続せず、requesterを中心とした星型構成です。
ブラウザ側では、
llama.cpp
   ↓
WASM
   ↓
RPC
   ↓
PeerManager
   ↓
WebRTC DataChannel
   ↓
別PCのブラウザ
という形になっています。
llama.cppから見るとpeerはRPC backendですが、そのRPC通信をブラウザではWebRTC DataChannelに載せています。
そのため、推論エンジンそのものをWeb用に作り直すのではなく、llama.cppの仕組みをそのままブラウザ間の分散計算へ持ってくることができます。
実際に大変だったのは、モデルそのものより
C++ / WASM / JavaScript / WebRTC / LAN
の境界部分でした。
同一LANなら必ずP2Pできると思っていましたが、物理PCで試すとhost candidateの交換までは成功してもICE接続が成立しない環境がありました。
原因を決め打ちせず、direct接続を基本にしつつ、必要なら会場LAN内のTURNサーバーを使えるようにしています。TURNは必須ではなく、direct接続できない環境向けのfallbackです。
軽量モデルでは複数peerを使った分散実行まで確認できましたが、大きなモデルではモデルデータの転送量が増えると通信が失敗する問題が出ました。
そこで、
を計測できるようにして、「分散されていないのか」「送信が詰まったのか」「受信側が追いついていないのか」を切り分けています。
apps/web(React)・apps/server(Hono)・packages/shared-types(共通の型)を1つのリポジトリにまとめました。言語もパッケージマネージャーも揃うので、担当じゃないところを読むのが楽ですAGENTS.mdにアーキテクチャの制約やコーディング規約をまとめて、AIに書かせるときも設計がブレないようにしました。「ドキュメントとコードが食い違っていないか機械的にチェックする」skillも仕込んでおきましたpackages/shared-typesに判別可能ユニオンで定義して、ドキュメントにも書きました。おかげで担当がバラバラでも、契約だけ見れば独立して進められました