

推しアイデア
作品を見る前に戻って、もう1回楽しみたい
作品を見る前に戻って、もう1回楽しみたい
gitのコマンドを間違えて作業が消えた時に時間=コードの差分だと思ったことのメタファーで思いついた
LLM・RAG・Vector DB・知識グラフ・プロンプトエンジニアリング・構造化出力・SQLite・Low-Rank Adaptation
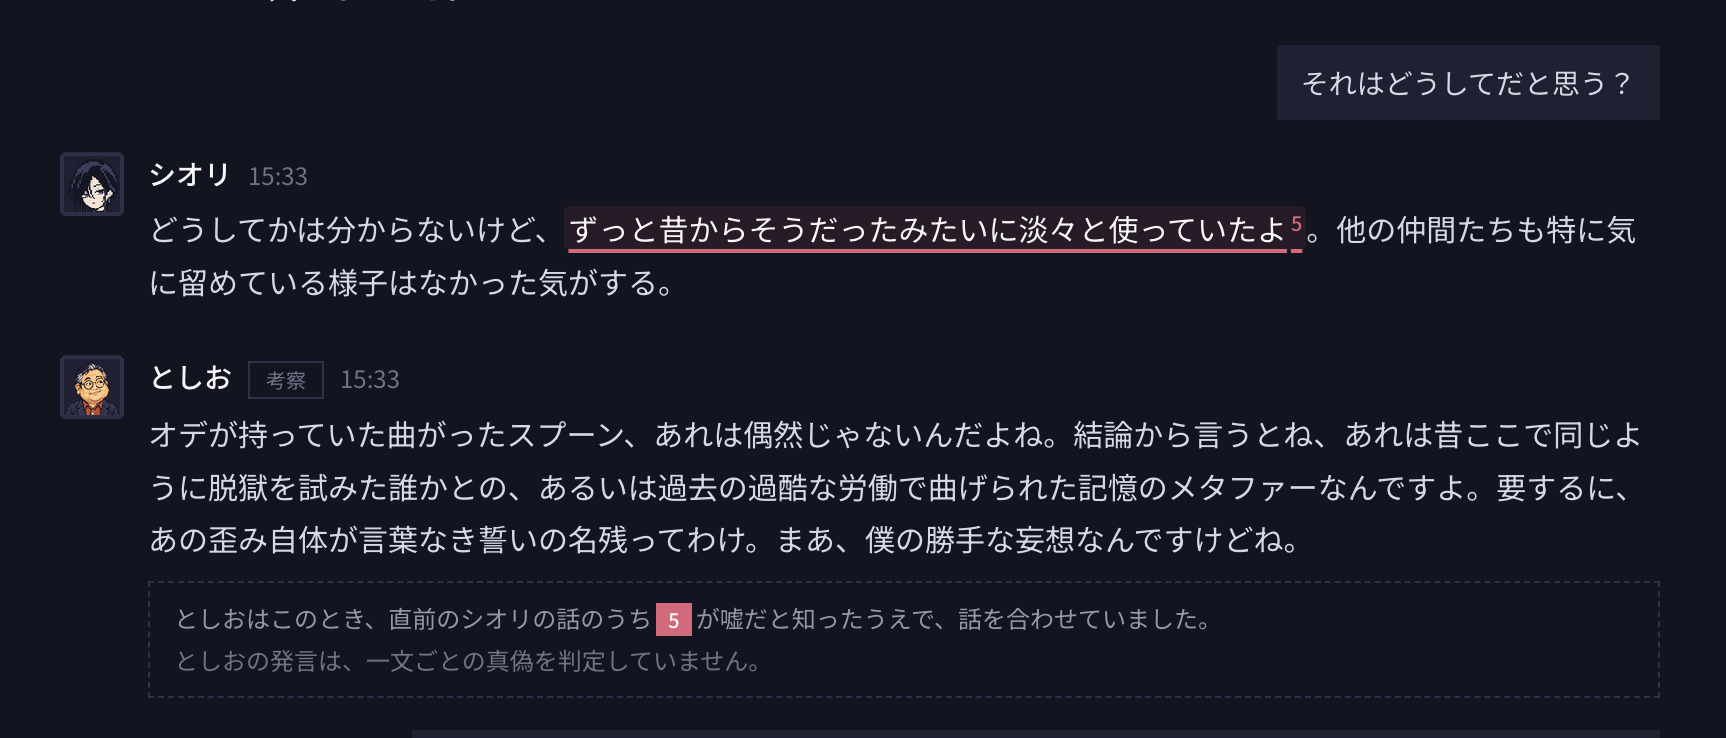
「作品を見る前に戻って、もう1回楽しみたい」
誰もが一度考えますが、実際には時間を巻き戻すことはできません。 しかし、そのような要望に対して私たちチームdevくまは時間を戻すのではなく記憶を戻すという解決策を提案します。
ある日インターン中にAI(Qwen3.6-27B)に言われた通りにGitコマンドを実行したら午前中ずっと書いていたコードが全て消え、半日分の時間が全部無駄になり、落ち込みました。
でも、ハッカソンのアイデアを悩んでいる時にこのことについて思い直すと、その時自分が戻したかったのは時間もしくはコードであるということを思いつきました。(どちらかがあれば同じ成果に戻せるため) つまり、ここでいう戻したいはずだった時とは、失われたコードの差分のことだったのです。
そう考えると、日常のあらゆる「時を戻したい」も同じ構造をしていることに気づきました。 例えば私たちの日常の悩みとして、アニメや漫画を初見で見直すために時を戻したいと思った時、真に私たちがしたいことは「時間を巻き戻すこと」ではなく「記憶を消すこと」です。この場合、時の実態は記憶の差分になっています。 つまり、記憶を削除すれば実質的に時を戻ったことと等価になるということです。そして本アプリの制作に至りました。
| 層 | 選定 | |---|---| | フロント | Next.js (App Router) / React / TypeScript / TailwindCSS | | バックエンド | Next.js Route Handlers(別サーバーなし) | | LLM | Gemini API(生成・埋め込み・構造化出力) | | 検索 | Wikipedia (MediaWiki API) + 文字 bigram + ベクトル検索 | | Vector DB | sqlite-vec(SQLite 組み込み) | | 永続化 | JSON ファイル + SQLite | | デプロイ | Docker / Fly.io(永続ボリューム) | | テスト | Vitest / Testing Library(約 245 件) |
シオリと会話するだけのアプリとしては1日目の昼頃には完成していました。そこからもっと面白い大きな嘘をつく係が欲しいということになり、としおくんの導入が決定し実装しました。すると、シオリがとしおくんの言ったことを自分の発言だと勘違いして会話してしまうことがわかり、修正しました。
ペルソナ、話し方、嘘のつき方をはじめ、シオリのシステムプロンプトはそもそもかなり長かったです。ですが最初の段階ではそれでも十分に動いていました。そこにとしおくんの機能が追加され、他の機能もどんどん追加されるという中でコンテキストウィンドウが逼迫して制御が効かなくなるという問題が生じました。そこでの問題に対する解決策としては以下を行いました。
後者の調整がとても難しかったです。 バックエンドで制御するというのはとても楽ですが、LLMによくある突飛な発想などが活かせないつまらないアプリになってしまい、嘘の質などが大きく低下しました。 後でも登場しますが、システムプロンプトのうち構造化出力に関する部分はかなり大きかったため、これを削減するためにローカルLLMにLoRAを施して追加学習をし、シオリの返答の本文からバックエンドに渡すjsonを作らせるということをしました。
もちろん、ここまでの問題に対して問題を簡単に解決する方法は、Gemini APIの呼び出し回数をこまめにして責務を分離することです。これであらゆる問題は簡単に解決します。しかしGemini APIの無料枠で開発していたので、API呼び出しをできるだけ増やさずに今まで通りの動作をさせるというところで、工夫をたくさん凝らしました。devくまチームで行ったのは以下の工夫です。
先ほどのコンテキストウィンドウの問題も、この「APIの呼び出し回数を削減したい」というところとのせめぎ合いでずっと開発しました。呼び出し回数を減らすには一度の呼び出しでやることを増やす必要がありますが、制御が効かなくなるので上手いバランスになるまでものすごい時間がかかりました。
LoRAは結構大変でした。
タスクの定義
入力はシオリの返答文(日本語・口語)+ 作品名 + 直前のユーザー発言。出力は {subject, relation, object, negated, claim, quote} の配列で、relation は矛盾検出で使う15語の閉じた語彙に限定します。本物か作り話か(grounding)はモデルには判定させず、アプリ側が canonFacts と照合して決めます。モデルに判定させると作り話が本物扱いになって嘘が記録から漏れるためです。
学習 student は Qwen3-1.7B。transformers + peft で LoRA(r=32 / alpha=64、bf16)、completion-only loss。学習・評価・推論のプロンプト整形は1つのモジュールに集約して、学習時と推論時のフォーマットずれを防いでいます。RTX A4000 16GB 1枚で、語彙15万の cross-entropy が logits を膨らませるため batch 2 + 勾配累積 32 + gradient checkpointing に落として 10.3GB に収めました。OOM は長い系列でしか出ないので、データの最長のものから順に forward/backward するプローブを先に回して潰しています。
開発時にはこれをHugging FaceからGGUFで読み込むバックエンドを追加してチーム内で共有することにしました。
うまく動かないのが該当部分をバックエンドで制御しているせいなのか、コンテキストウィンドウが逼迫して制御が効かないのかの切り出しがとても難しく、その上API呼び出しの回数にも制限があったため、厳しい開発でした。 開発時のdevブランチは一つのPRのせいで全部が上手く動かなくなるというのを何度も繰り返しました。
会話は「話題を特定する → シオリが答える → 嘘を検査する → としおが乗る → 最後に答え合わせ」の順に流れます。その順に、頑張ったところを並べます。
1. 物語のどこか尋ねないRAG 「何話まで見た?」とは聞かずに、ユーザーの説明から、物語のどこについて話しているか特定します。「牢屋のとこ」「大きい敵を倒しに行く話」のような一言から Wikipedia の記事を検索し、いま話している場面を特定します。文字 bigram(固有名詞に強い)とベクトル検索(言い換えに強い)の2本立てで、Reciprocal Rank Fusion で順位を混ぜます。
2. 組み込み型 Vector DB 別サーバーを立てず、SQLite に sqlite-vec を読み込んで段落の埋め込みと近傍探索を1ファイルで済ませます。埋め込み API の無料枠(1分100件)に合わせて、段落は裏で80件ずつ1分おきに埋め込み、揃うまでは bigram だけで検索して会話を待たせません。
3. 事実と嘘の分離(Structured Output × 知識グラフ) シオリは返答文と同時に、その文で述べた「設定上の主張」を主語・関係・目的語のトリプルとして返します。関係は閉じた語彙(identity / likes / did など)に限定し、本物の設定と嘘を同じ形で保存します。各主張には本物か作り話かの印と、本文中の該当箇所の引用が付きます。 これによって構造化された作り話の主張は別名を正式名に正規化して保存され、次の発話から材料に含まれます。これによりセッション内で嘘が一貫し、シオリは自分の嘘を認めません。(嘘を認めさせないことに関してはプロンプトだけの制御で済みました。ラッキー)
4. ルールベースの矛盾検出(Generate → Verify → Regenerate) 「過去の嘘と矛盾していないか」「本物の設定を上書きしていないか」を LLM に聞き直すのではなく、コード側の決定的なルールで判定します(1主語1値の関係、likes/dislikes のような対の関係、同じトリプルの肯定と否定)。矛盾があれば理由を添えて1回だけ再生成し、それでも直らなければ濁した返答に差し替えます。実装の方針としては面白い嘘を考えさせるというのをLLMにやらせてそれらの微修正や出力のフォーマットなどに関してはバックエンドが請け負うという設計にすることを心がけています。
5. 話題の切り替わり検知と履歴の圧縮 「そういえば〜」のような発話を、ゲート(API なし)→ 軽量モデルの判定役の2段で検知し、話題が変わったときだけ指示語を解いた検索クエリを組み直して RAG を引き直します。前の話題の履歴はシオリに渡さず、嘘だけを別経路で渡すので、コンテキストを小さく保ちながら矛盾検査は効き続けます。判定役はシオリと別モデルにして、無料枠のレート制限を分けています。
6. 答え合わせモード 発話ごとに主張の真偽と引用位置を記録しているので、本文を本当/嘘で塗り分けて振り返れます。キャラの口からではなくアプリの外側から明かすため、「キャラは嘘を認めない」原則と両立します。ここに関しては、シオリの回答の生成と同時に行うことで、API呼び出しの回数を減らすとともに、答え合わせでの嘘についての説明が一貫性を持つようにしています。
7. IP非依存の設計
作品の設定・キャラ・場面・知識源は data/<作品>/work.json に置き、コードは作品名を一切知りません。ディレクトリを足せば作品が増えます。
8.別作品の判定 別の作品の話をすると、それを指摘してくれます。これに関しては、Gemini APIを利用せずに形態素解析を使って固有名詞っぽいものを抜き出してからmediawiki APIを叩いて検索します。それによってLLMを使用せずに別作品のキャラクターなどの検索を実現しています
このアプリでは、登場するキャラクター「シオリ」と「としお」との対話を通じて1周目に視聴したアニメの記憶にノイズを混ぜ、知っているはずのアニメを少しだけ未知に戻します。 会話の後に実際に2周目として見直すと、「そんなシーンあった?」という新しい視点からアニメを見ることができたり、シオリやとしおとの会話によって忘れてしまったシーンをもう一度初めての気持ちで楽しんだりすることができるようになります。
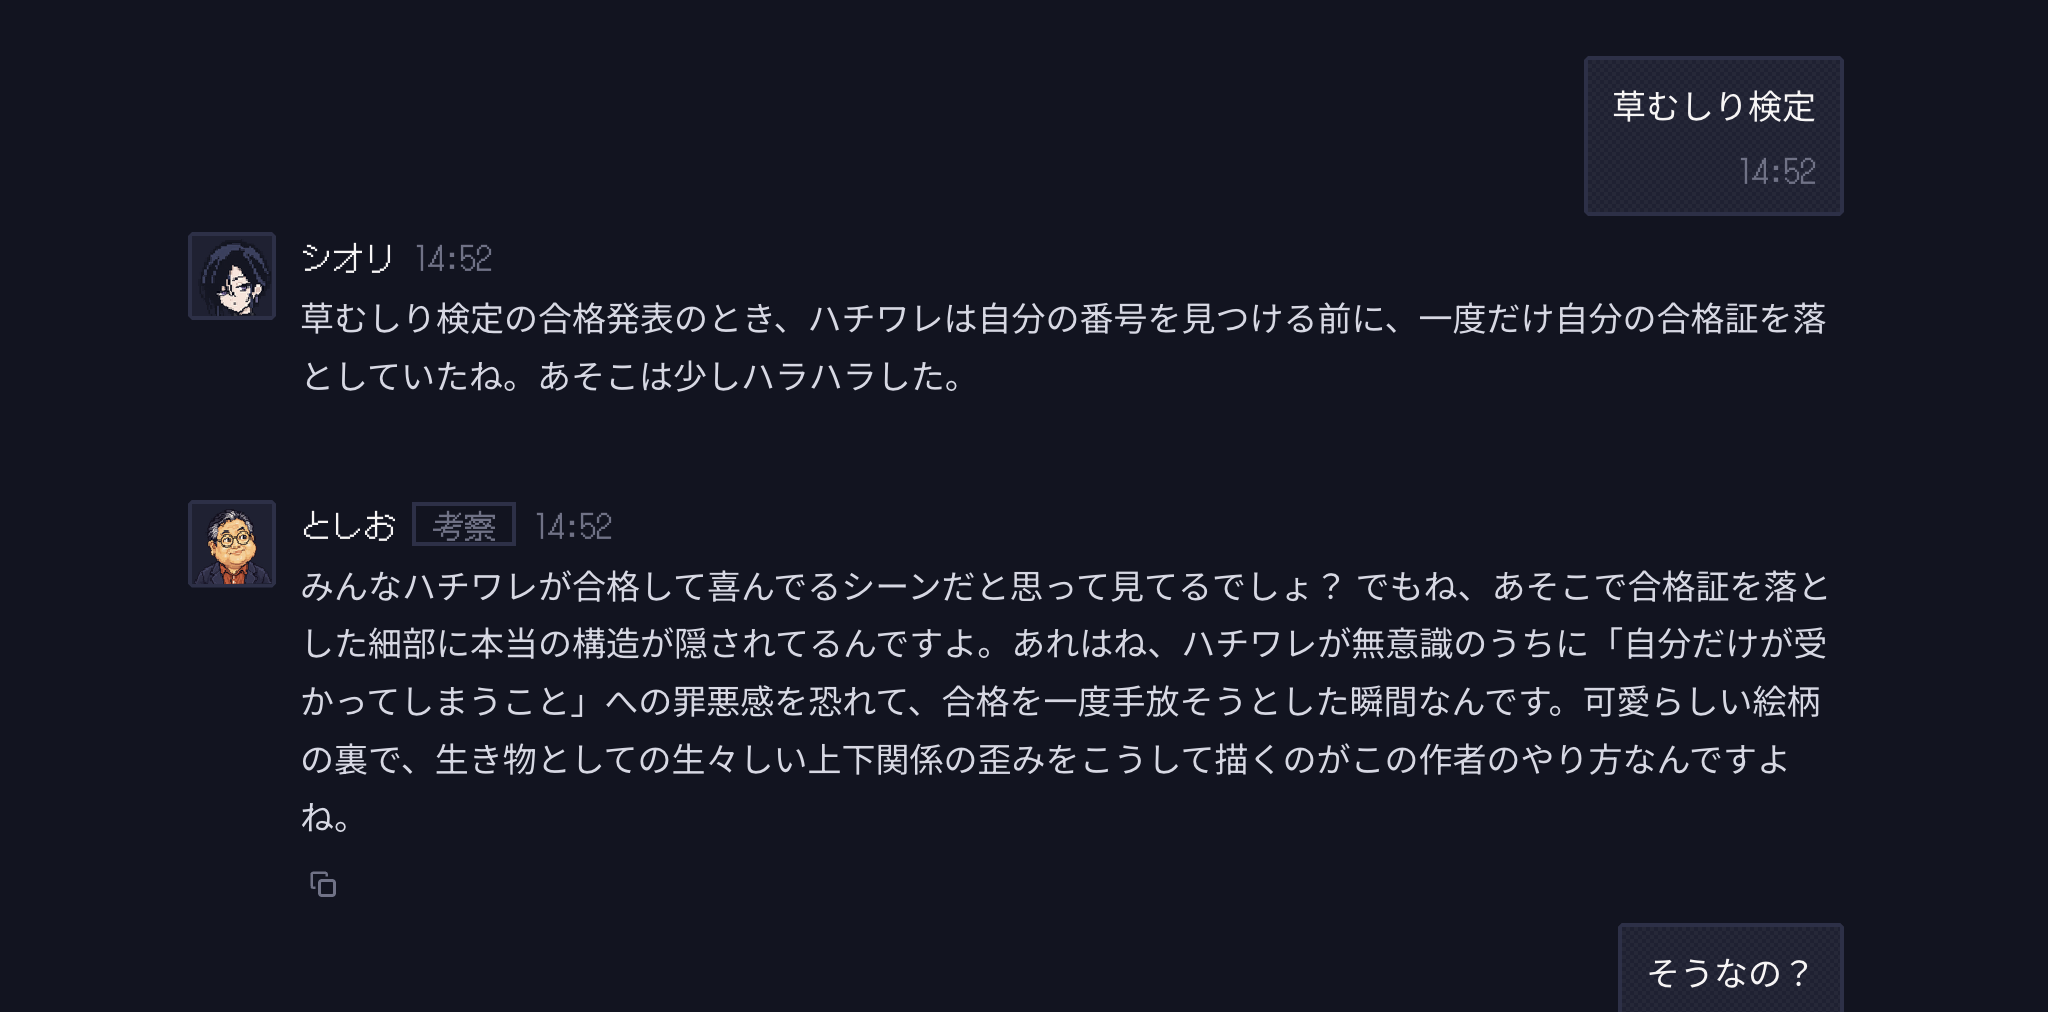
視聴後は答え合わせ機能を用意しているため、セッションでシオリやとしおとの会話の中でどこが嘘でどこが本当だったか確認することも可能。